Plan de Disaster Recovery para operaciones críticas: guión, pruebas y runbook operativo
Cuando un data center queda inaccesible, la diferencia entre recuperación y pérdida de negocio son los procedimientos ensayados — esta guía ofrece un DRP aplicable a operaciones críticas con escenarios, criterios de RTO/RPO, runbooks y checklist de pruebas.
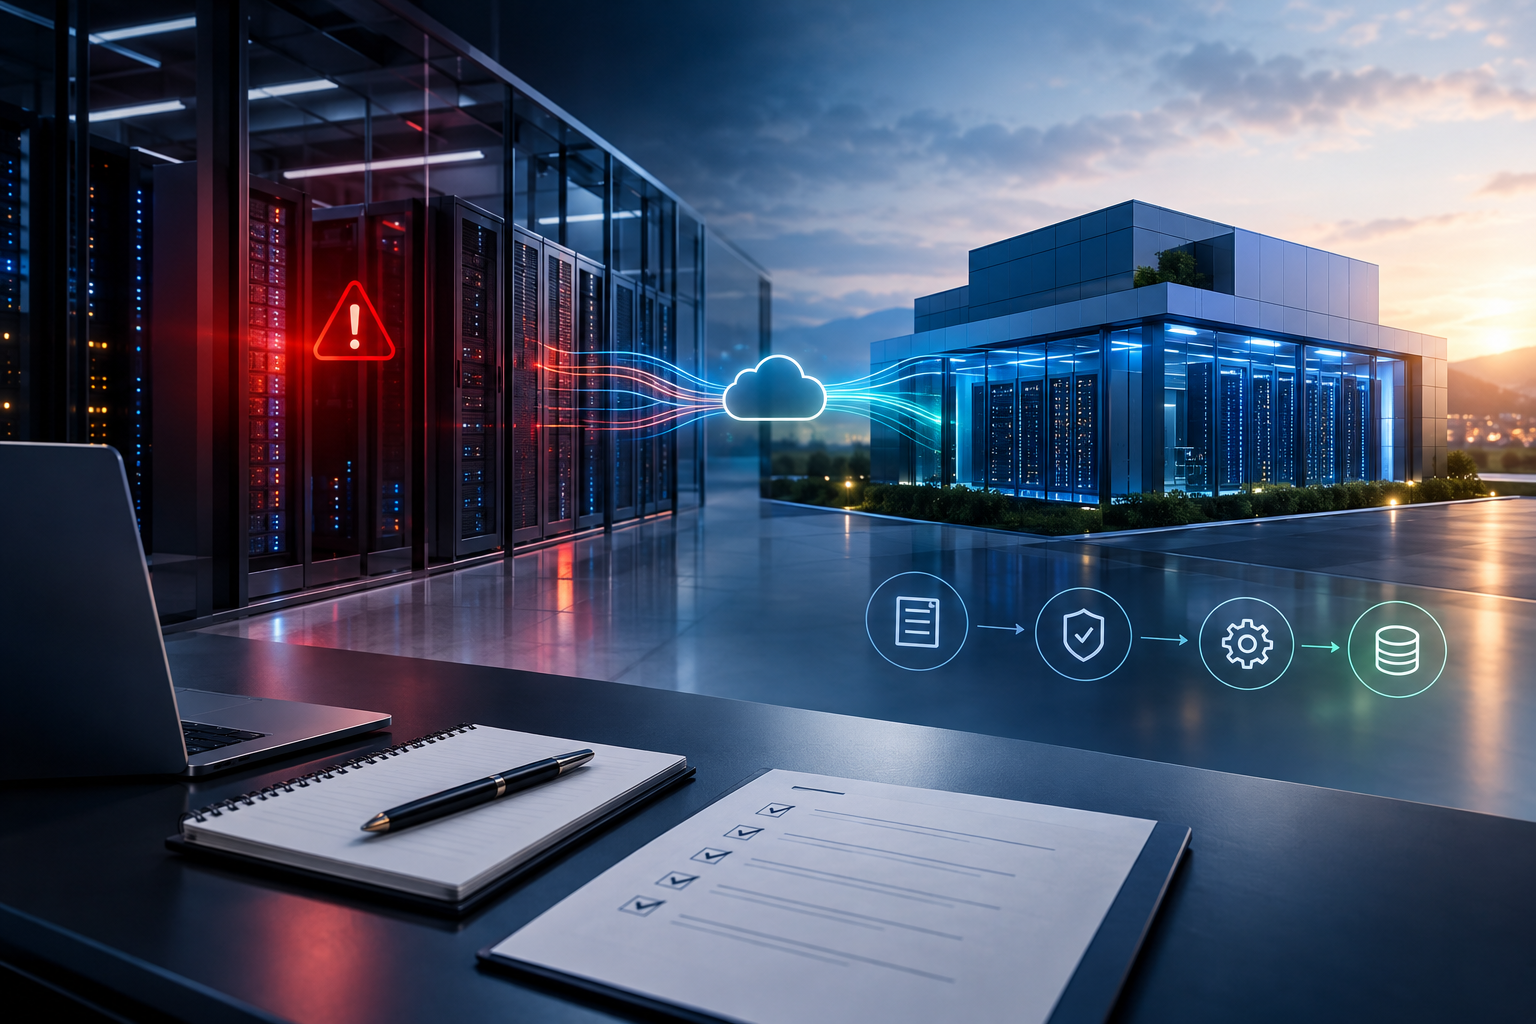
Cuando sistemas críticos pierden conectividad o un sitio completo deja de estar disponible, la ejecución bajo presión decide entre recuperación y daño prolongado: los equipos que siguen guiones probados restablecen servicios con previsibilidad; los que improvisan asumen riesgos. Esta guía presenta un Plan de Disaster Recovery (DRP) operativo para entornos críticos —no teoría— con escenarios (fallo de enlace, pérdida total de sitio, corrupción de datos), criterios prácticos para RTO/RPO, runbooks accionables y un calendario de pruebas aplicable hoy.
Tesis central: un DRP eficaz para entornos críticos alinea tres elementos concretos —decisiones de arquitectura (sitio y replicación), playbooks operativos y un ciclo de pruebas validado— y solo puede validarse mediante simulaciones que preserven seguridad y cumplimiento. A continuación hay definiciones mínimas, límites, causas, efectos y procedimientos paso a paso que su equipo puede adaptar.
¿Qué escenarios de interrupción priorizar?
Priorice tres escenarios que obligan a respuestas técnicas y decisiones de negocio distintas. Son ilustrativos como plantillas para validar decisiones:
- Interrupción de enlace: pérdida de conectividad entre clientes y el centro de datos primario o entre sitios; normalmente requiere reruteo de tráfico y activación parcial de servicios redundantes.
- Fallo total de sitio: indisponibilidad completa del centro de datos primario (infraestructura física) que exige activación del sitio secundario y verificación de dependencias externas.
- Corrupción de datos o compromiso lógico: los datos replicados pueden contaminarse; la respuesta requiere aislamiento, análisis forense y recuperación desde puntos protegidos (snapshots, backups fuera de la cadena de réplica).
Cada escenario conlleva consecuencias operativas distintas: un fallo de circuito puede permitir un conmutado localizado; la pérdida de sitio exige plan de comunicación y conmutación a nivel de infraestructura; la corrupción de datos impone políticas de retención y puntos de restauración. Use los escenarios como plantillas para su DRP.
¿Cuáles son los elementos mínimos de un DRP aplicable a misión crítica?
Un DRP accionable debe ser breve, ejecutable y comprobable. Elementos mínimos:
- Inventario vivo: listado de aplicaciones, dependencias (DNS, autenticación, terceros), volúmenes de datos críticos y responsables.
- Mapa de dependencias: flujos de red y servicios que señalen puntos únicos de falla entre capas de infra y middleware.
- Criterios de decisión: umbrales que activan el modo DR (ej.: indisponibilidad mayor a X minutos, errores de integridad superiores a Y%) —deben vincularse a RTO/RPO acordados con el negocio.
- Runbooks por escenario: secuencias paso a paso con checkpoints, contactos y aprobaciones para la activación del sitio secundario.
- Planes de comunicación: listas de contactos, mensajes estándar para stakeholders y procedimientos de comunicación.
- Registros y evidencia: logs de decisiones y resultados de pruebas con timestamps y responsables.
Sin inventario actualizado y mapa de dependencias, los runbooks se vuelven checklists inútiles. Actualice documentación ante cualquier cambio de arquitectura o proveedor.
¿Cómo definir RTO y RPO sin adivinar?
Definir RTO (Recovery Time Objective) y RPO (Recovery Point Objective) implica traducir impacto de negocio en umbrales operativos. Marco práctico:
- Clasifique cargas por criticidad (A,B,C) según pérdida tolerable: A = impacto inmediato al negocio; C = impacto limitado.
- Asocie a cada clase ventanas máximas tolerables de downtime y pérdida de datos mediante diálogo con finanzas y producto.
- Mapee costos incrementales de arquitectura para cada RTO/RPO: proximidad entre sitios, replicación síncrona, IOPS adicionales, operaciones de validación.
- Defina prioridades: sistemas A suelen requerir RTO corto; evalúe si el coste de replicación síncrona y sitios cercanos está justificado.
Trade-off habitual: reducir RTO/RPO aumenta complejidad y coste. Para cargas A, la falta de inversión puede significar riesgo comercial. Documente las decisiones y niveles de servicio esperados.
¿Cuándo elegir replicación síncrona o asíncrona?
Decida según latencia tolerable, consistencia y coste operacional:
- Replicación síncrona: garantiza consistencia entre primario y secundario al commit; indicada cuando no se admite pérdida de datos. Penaliza rendimiento y exige baja latencia entre sitios—aumenta coste y complejidad.
- Replicación asíncrona: reduce impacto en latencia del primario, permite mayores distancias y costes de red menores; implica ventana de exposición entre último commit y réplica.
- Snapshots y backups independientes: esenciales contra corrupción lógica—la replicación puede propagar corrupción; mantenga puntos de recuperación fuera de la cadena de réplica.
En la práctica combine técnicas: síncrona para volúmenes transaccionales críticos, asíncrona para datos menos sensibles y snapshots periódicos para recuperación lógica.
Runbook estándar: triage, aislamiento y activación del sitio secundario (paso a paso)
Los runbooks deben ser procedimientos ejecutables con checkpoints claros. Flujo plantilla:
- Triage inicial (0–15 min): identificar alcance (aplicación, red, storage). Verificar alertas automáticas y confirmar con responsables. Registrar hora y responsable.
- Aislamiento y contención (15–45 min): aislar fuentes de error para evitar propagación (pausar replicación, aislar segmentos de red). Si se sospecha corrupción, detener sincronización que propague el fallo.
- Decisión de activación (45–90 min): comparar impacto con criterios de RTO/RPO documentados. Obtener aprobación del comité de incidentes si la política lo exige.
- Activación del sitio secundario:
- Promover endpoints y rutas DNS bajo procedimiento controlado (documentar TTL y orden de updates).
- Validar integridad de servicios críticos en el secundario con pruebas de humo.
- Habilitar capacidades de lectura/escritura según arquitectura y registrar latencias observadas.
- Operación en modo DR: ejecutar plan de continuidad de negocio; monitorizar rendimiento y recopilar evidencias para post-mortem.
- Retorno y validación: planear failback al primario solo después de validación completa y sincronización; documentar el proceso de sincronización y el orden de reversión.
Cada paso requiere responsables con autoridad y canales de comunicación pre-aprobados para evitar demoras.
Checklist de pruebas: tabletop → failover parcial → failover completo
Pruebas escalonadas para reducir riesgo y aumentar confianza operativa:
- Tabletop (sin impacto): simulación en sala con stakeholders para revisar decisiones y tiempos de respuesta; ideal antes de pruebas técnicas.
- Failover parcial (entorno controlado): activación de servicios menos críticos en sitio secundario, validación de replicación y pruebas de humo y dependencias.
- Failover completo (ventana controlada): activación total del sitio secundario con tráfico real; ejecutar solo tras múltiples pruebas parciales exitosas.
En todas las pruebas registre métricas: timestamps de cada paso, fallos detectados, tiempos de recuperación por servicio y aprobaciones documentadas. Estos artefactos sirven para auditoría y mejora continua.
Errores comunes y cómo evitarlos
- Solo probar una vez: establecer cadencia y documentar resultados.
- Ignorar dependencias externas: incluir mapas y contactos de proveedores.
- No aislar corrupción lógica: la replicación puede propagar corrupción; mantenga backups y snapshots fuera de la cadena de réplica.
- Comunicación insuficiente: integrar planes de comunicación al DRP para acelerar decisiones.
Próximo paso y oferta MVX
Si desea convertir este guion en un DRP validado para su entorno, comience por un diagnóstico y una simulación controlada. MVX ofrece diagnóstico consultivo y workshops técnicos para validar runbooks y ejecutar simulaciones de failover con su equipo. Solicite diagnóstico de DR vía /pt/contact.
Para decisiones de arquitectura que impliquen replicación híbrida o colocación de cargas, consulte recursos en Cloud & Edge y opciones de Colocation. Agende un workshop técnico con MVX para probar escenarios específicos y recopilar la evidencia que su operación necesita para actuar bajo presión.