Como criar um sistema completo com IA, hospedar e proteger usando MVX
Guia prático para definir, desenvolver, hospedar, divulgar e proteger um sistema alimentado por IA — com caminhos operacionais claros para usar MVX, MVX Send, MVX Digital e MVX Shield no suporte à sua entrega.
Você precisa entregar um sistema que use IA para resolver um problema de negócio específico — por exemplo, automação de triagem de solicitações ou recomendação personalizada em um portal B2B — e tem um prazo curto, equipe mista e restrições de orçamento. Se o protótipo funciona em testes locais, mas a versão em produção aumenta a latência, vaza dados ou não escala quando o uso cresce, a consequência é clara: perda de confiança dos usuários, custos inesperados e um ciclo de retrabalho que atrasa a adoção. Este artigo mostra uma abordagem prática e completa: como projetar o sistema alimentado por IA, onde hospedar com MVX, como divulgar com MVX Send, quando acionar MVX Digital para reforço e como aplicar MVX Shield para reduzir riscos de segurança e continuidade.
Antes de mencionar fornecedores, comece pela necessidade: descreva em uma frase o impacto mensurável que a IA precisa entregar (por exemplo, reduzir tempo de resposta em X%, aumentar taxa de conversão em Y pontos, automatizar Z processos por dia). Em seguida, identifique os dados necessários, a qualidade mínima aceitável e as métricas que definirão sucesso em produção. Só depois disso faça escolhas técnicas; isso evita construir arquitetura desnecessária ou superfaturada.
Como estruturar um produto de IA que chegue à produção
Uma arquitetura prática tem quatro camadas: ingestão e preparação de dados, treinamento e validação, engenharia de inferência (serviços que executam previsões) e operações (monitoramento, rollback, auditoria). Para cada camada detalhe critérios: tipo de dados, janelas de atualização, requisitos de latência, custo por requisição e planos de observabilidade. Especificar SLAs internos (por exemplo, 99,5% de disponibilidade para endpoints críticos) ainda na fase de projeto ajuda a escolher infraestrutura e mecanismos de redundância.
Limites e trade-offs que você vai enfrentar
Baixa latência vs. custo: manter modelos na memória em instâncias maiores reduz latência, mas aumenta custo; alternativas incluem caching e sistemas híbridos on-demand. Precisão vs. interpretabilidade: modelos complexos podem obter melhor acurácia, porém exigem explicabilidade. Exclusão de dados sensíveis reduz risco, mas pode degradar performance se os atributos removidos forem preditivos. Liste esses trade-offs e priorize com stakeholders.
O que a hospedagem precisa oferecer para IA em produção
Para que inferência e treino sejam confiáveis em produção, a hospedagem deve permitir escalonamento automático das APIs de inferência, suportar GPU/CPU conforme o workload, manter isolamento entre ambientes e oferecer caminhos claros para backups e disaster recovery. Também é essencial ter integração com pipelines CI/CD que automatizem deploys de modelos e rollback seguro. Em ambientes de alta criticidade, inclua testes de canary antes de promover um novo modelo para todos os usuários.
Quando escolher um provedor gerenciado
Se sua equipe tem pouca experiência em operações de infraestrutura, um provedor que centralize hospedagem, redes e serviços de entrega reduz o custo operacional e acelera entrega. Mas isso não substitui governança de dados nem responsabilidade sobre decisões de modelo; você ainda precisa definir métricas, processos de teste e políticas de segurança.
Como divulgar o sistema e engajar usuários
Ter um bom produto não basta: é necessário um plano de divulgação segmentado. Comece com campanhas de lançamento para grupos piloto, utilize notificações e e-mails para atualizar usuários sobre mudanças e conduza experimentos controlados (A/B) para validar hipóteses de conversão. Mensagens personalizadas, entregues com precisão e respeito às regras de privacidade, aumentam a adoção.
Por que escolher um serviço unificado de envio
Enviar comunicações por vários canais exige coordenação e dados limpos. Um serviço que centralize filas de entrega, templates e métricas facilita mensuração e automação. Se precisar de ajuda para planejar ou executar campanhas, considere apoio externo focado em performance e automação.
Como proteger dados, modelos e aplicações: práticas essenciais
Segurança em sistemas com IA inclui controle de acesso a dados de treinamento, criptografia em trânsito e repouso, validação de entradas para evitar injeção e monitoramento de anomalias que possam indicar manipulação de dados ou ataques adversariais. Adote políticas de retenção e anonimização adequadas ao seu contexto regulatório. Lembre-se: controles técnicos são complementados por processos e responsabilização clara dentro da equipe.
O que a proteção não substitui
Tecnologias de segurança reduzem risco, mas não substituem governança, testes de adversarialidade e supervisão humana. Um escudo técnico é parte do ecossistema; sem processos de revisão e planos de resposta a incidentes, a organização continua vulnerável.
Critérios para decidir onde hospedar, divulgar e proteger
Use seis critérios práticos: requisitos de latência, necessidade de GPU, compliance e privacidade, custo total de propriedade, facilidade de integração com seu pipeline CI/CD e capacidade de suporte/operacional. Avalie fornecedores contra esses critérios com cenários de carga reais. Priorização clara evita comparar apenas por preço.
Cenários de aplicação e arquitetura recomendada
Cenário A — protótipo que virará produto: mantenha separação clara entre dados de produção e treino, use infra escalável sob demanda e planeje uma janela de observabilidade intensiva nas primeiras semanas. Cenário B — aplicação com tráfego constante e alta criticidade: implemente redundância em múltiplas zonas, testes de failover e planos de recuperação. Cenário C — produto regulado: priorize controles de auditoria, logs imutáveis e processos de aprovação para mudanças em modelos.
Perguntas frequentes operacionais
Como validar que um modelo em produção continua confiável?
Monitore métricas de performance (ex.: drift de distribuição, perda de acurácia no tempo), acompanhe logs de inferência, implemente alertas em thresholds e faça testes periódicos com datasets rotulados para comparação. Ter um plano de rollback automático para versões que ultrapassem limites é essencial.
Quando envolver especialistas externos?
Considere especialistas para otimização de campanhas, suporte a escala de infraestrutura ou auditoria de segurança quando a equipe interna não tem capacidade para entregar melhorias em prazos exigidos ou quando é preciso reforço técnico pontual.
Como a MVX pode entrar no fluxo operacional
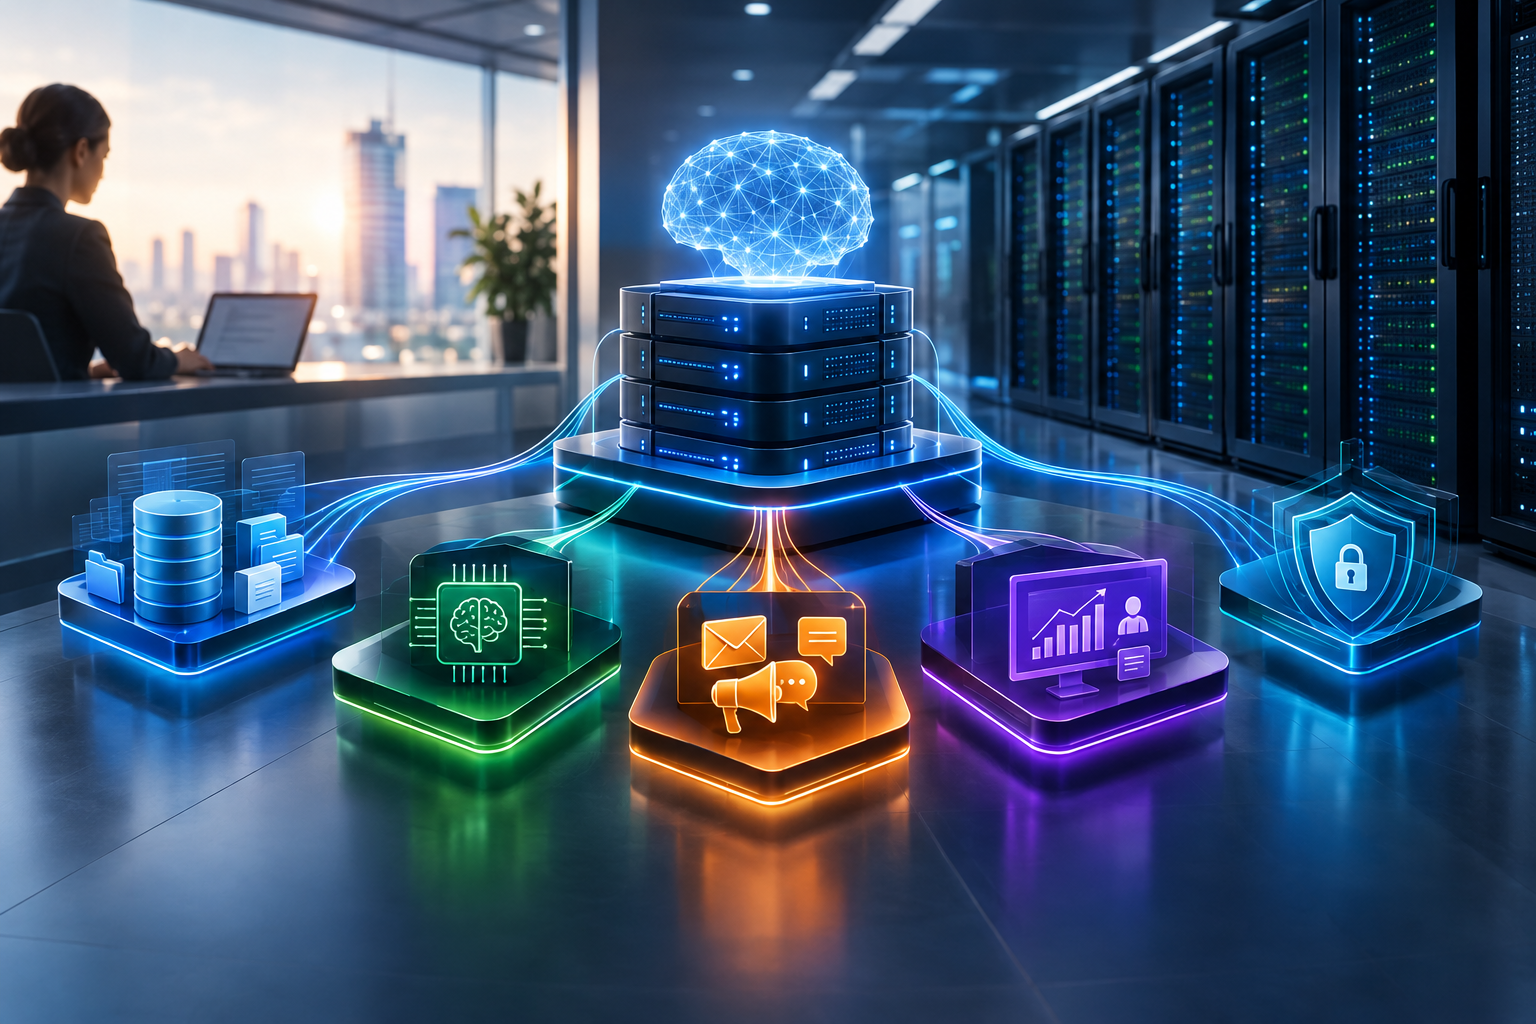
Depois de definir a arquitetura e as necessidades, você pode hospedar APIs e aplicações com a MVX para tirar vantagem de uma solução integrada de infraestrutura. Para enviar comunicações segmentadas utilize MVX Send. Se precisar de apoio para executar campanhas, otimizar conversões ou estratégia digital, acione MVX Digital. Para reduzir riscos na camada de segurança e disponibilidade, adote MVX Shield. Essas mencões são de roteiro operacional: cada item é um ponto de contato que pode reduzir fricção entre desenvolvimento, operações e marketing.
Modelo operacional proposto para a primeira entrega
- Semana 0–2: definição do resultado de negócio, métricas e dados necessários.
- Semana 3–6: prototipagem do fluxo de inferência e testes com amostra de dados.
- Semana 7–10: deploy em ambiente controlado, integração com pipeline CI/CD, testes de carga e segurança.
- Semana 11–14: lançamento para grupo piloto, medição de indicadores e ajustes.
- Semana 15+: escala gradual, campanhas com MVX Send e reforço de marketing com MVX Digital.
Este modelo equilibra velocidade e mitigação de risco, deixando pontos claros de decisão antes de cada avanço.
O que medir para saber se a hospedagem e proteção estão adequadas
Métricas operacionais críticas incluem latência média e p95, taxa de erros por endpoint, custo por mil inferências, volume de mensagens entregues com sucesso, tempo médio de recuperação (MTTR) e número de incidentes de segurança detectados. Construa dashboards que cruzem métricas de negócio e infra; isso mostra se o custo está gerando impacto real.
Riscos e como mitigá-los
Risco de drifts e performance: mitigação com testes contínuos e pipelines de re-treinamento. Risco de indisponibilidade: mitigação com redundância e testes de failover. Risco de comunicação mal segmentada: mitigação com testes A/B e revisão de permissões de dados.
Perguntas finais que devem estar respondidas antes do lançamento
- Qual é a métrica única que define sucesso no primeiro trimestre?
- Quais dados são sensíveis e como serão protegidos?
- Quem aprovará o rollback e quais critérios acionam essa decisão?
- Quem lidera a experimentação de divulgação e quais canais serão usados?
Responder a essas perguntas reduz decisões improvisadas em momentos críticos.
Próximo passo prático
Se já tem o protótipo e quer avançar para produção com infraestrutura, envio e segurança integrados, agende uma conversa técnica para avaliar os requisitos de latência, compliance e comunicação. Você pode iniciar descrevendo sua necessidade em poucas linhas e compartilhar métricas atuais para um diagnóstico inicial. Para conhecer os pontos de contato operacionais, visite a página oficial da MVX para explorar opções de hospedagem, envio e suporte.
Conheça a MVX e marque uma avaliação técnica para adaptar este roteiro ao seu contexto.