Como a MVX ajuda sua empresa a crescer com Data Center, Digital, Shield e Send
Quando um pico de tráfego transforma uma janela de deploy em uma crise, a consequência é clara: perda de receita, clientes insatisfeitos e retrabalho. Este texto mostra um roteiro prático para ordenar infraestrutura (Data Center), serviços digitais (Digital), proteção (Shield) e canais de entrega (Send) de forma coordenada — o que cada pilar resolve, limitações, critérios de decisão e um plano de 90 dias para começar.
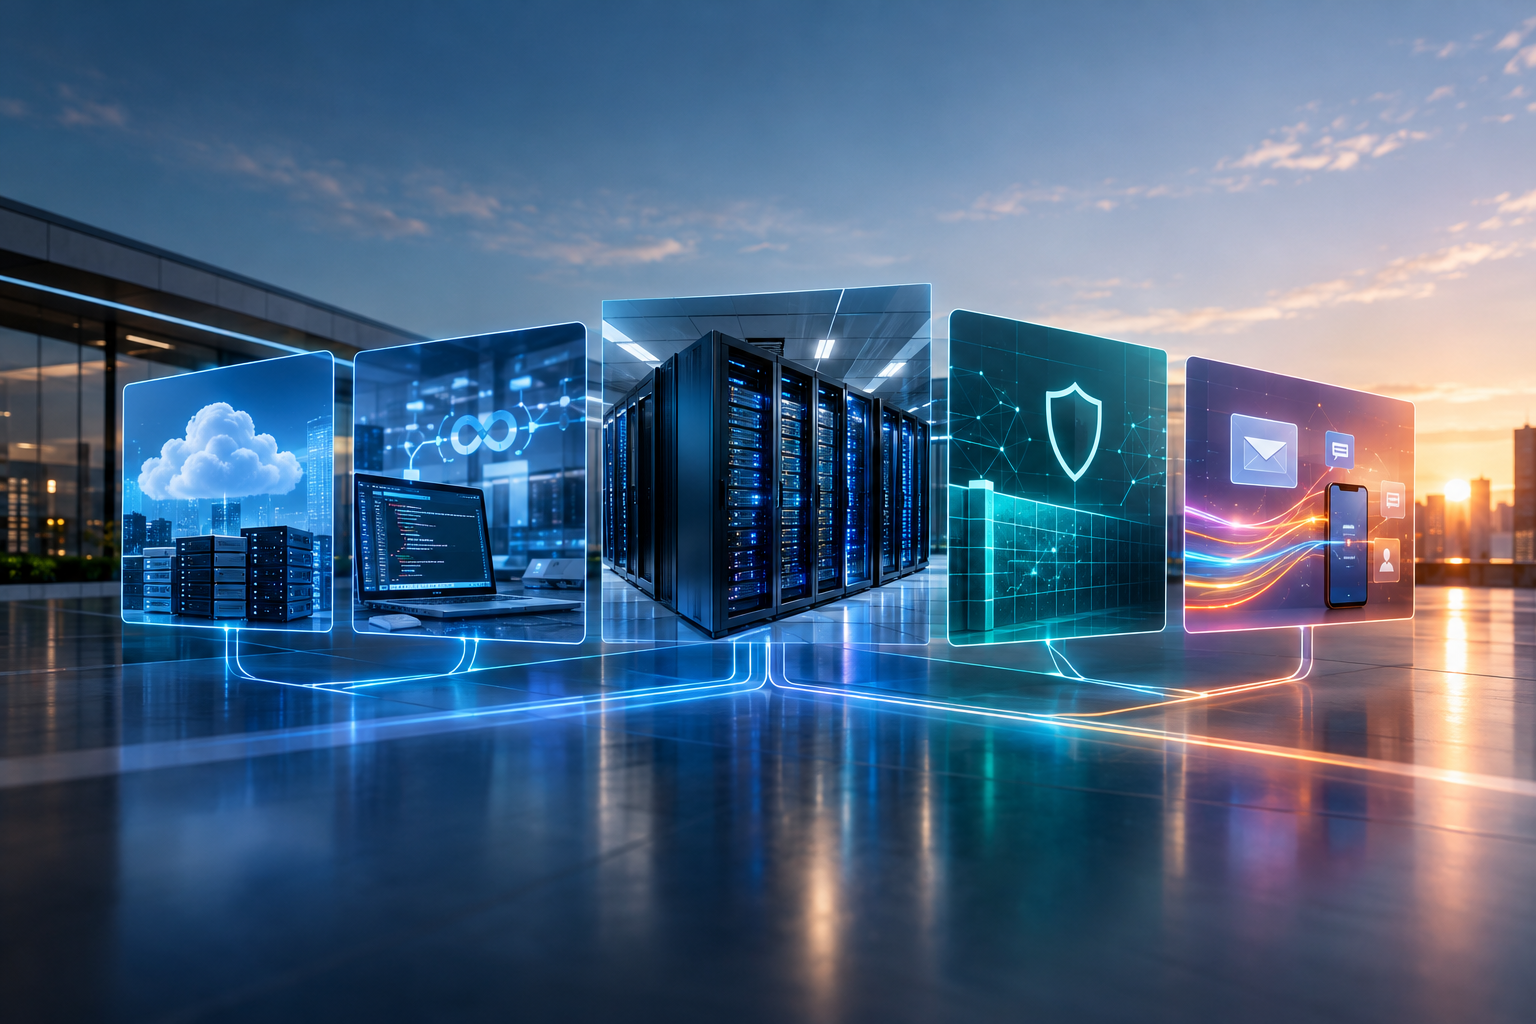
Você está operando uma aplicação crítica e, em um dia de pico, os tempos de resposta disparam, backups falham e as notificações para clientes não chegam. O custo imediato é financeiro; o custo mais duradouro é a confiança na marca. Quando esse cenário ocorre, decisões urgentes — aumentar instâncias, alterar rotas de tráfego, reconfigurar firewall — costumam resolver no curto prazo, mas aumentam complexidade e custo no médio prazo.
Esta peça parte desse gatilho operacional e apresenta uma tese prática: ordenar capacidade física, serviços digitais, controles de proteção e canais de entrega em um modelo coerente reduz risco e cria espaço para crescimento previsível. Nas seções a seguir você terá critérios concretos para decidir, entendimento dos trade-offs e um roteiro acionável para os primeiros 90 dias.
Depois de explicar princípios e opções, descrevemos como a MVX aborda esses quatro pilares de forma modular — diagnóstico, projeto, piloto e escalonamento — sem prometer soluções padronizadas. A referência ao site oficial está no fim para quem quiser iniciar o diagnóstico.
Quando optar por Data Center físico versus nuvem pública?
A escolha não é dicotômica; é contextual. Data Center físico (colocation ou rack dedicado) faz sentido quando você precisa de latências determinísticas, I/O elevado e controle físico por requisitos regulatórios. Nuvem pública é preferível para elasticidade, provisão rápida e modelos OPEX. Entre os extremos, modelos híbridos e colocation com links para várias nuvens oferecem um meio-termo esperto.
Critérios práticos para decidir:
- Perfil da carga: aplicações com IOPS intensivo e picos previsíveis tendem a se beneficiar de infraestrutura dedicada.
- Regulação e compliance: quando segregação física de dados é exigida, colocation pode ser mandatória.
- Custo total em 3–5 anos: inclua custos de pessoal, licenças, energia e conectividade, não apenas o equipamento.
- Capacidade de operação: se sua equipe não consegue operar stacks complexos, a nuvem gerenciada reduz risco operacional.
O que “Digital” entrega e o que não substitui
Digital reúne práticas e serviços que transformam recursos em plataforma: automação de provisão, pipelines CI/CD, observabilidade e gestão de custo. O objetivo é transformar infraestrutura em produto interno, reduzindo o tempo entre ideia e entrega.
Cenários onde Digital faz diferença imediata:
- Times pequenos que precisam escalar produtos: automação e testes permitem crescimento sem multiplicar headcount.
- Empresas em transformação: padronizar infra como código e migrar cargas não sensíveis primeiro.
- Organizações com múltiplos produtos: unificar métricas e monitoramento para visibilidade por cliente.
Limites do Digital: não substitui governança de risco, definição clara de SLOs nem cultura de incident response. Automação sem políticas cria dívida técnica — é obrigatório integrar políticas de segurança e limites de custo.
Shield: priorizar proteção sem buscar impossível invulnerabilidade
Shield é a camada que combina prevenção, detecção e resposta. Prevenção inclui hardening de sistemas; detecção envolve logs, métricas e correlações; resposta é playbooks com responsáveis e prazos. Um programa eficaz equilibra investimento em prevenção e capacidade de resposta, porque nem toda ameaça é previsível.
Trade-offs típicos:
- Isolamento aumenta segurança, porém encarece integrações e operações.
- Monitoramento aprofundado exige armazenamento de dados e equipe para analisar alertas.
- Redundância amplia resiliência, mas tem impacto direto no custo e na complexidade do deploy.
Priorize Shield a partir destas perguntas:
- Quais ativos causariam maior impacto financeiro ou reputacional se indisponíveis?
- Qual RTO e RPO seu negócio pode tolerar?
- Que requisitos de auditoria e conformidade existem para seu setor?
Send: garantir entrega de mensagens e notificações críticas
Send é a camada dedicada a entrega — e não apenas a ferramenta de envio. Trata-se de gerenciar filas, retries, fallback, escalonamento de tentativas e métricas de entregabilidade. Empresas que subestimam essa camada descobrem que a qualidade dos dados e o gerenciamento de filas são mais determinantes do que o provedor de entrega escolhido.
Quando priorizar Send:
- Alto volume de notificações transacionais (financeiro, logística, alertas de segurança);
- Workflows assíncronos que dependem de confirmações externas;
- Necessidade de SLA de comunicação com parceiros.
Limitações: Send não corrige má qualidade de dados nem lógica de negócio falha; são necessários pipelines de transformação upstream e políticas claras de retry e dead-letter.
Como combinar os quatro pilares em um plano prático
Um roteiro sucinto e aplicável:
- Diagnóstico orientado a risco: mapeie ativos, dependências e pontos únicos de falha.
- Definição por domínio: decida para cada produto onde ele deve residir (colocation, nuvem ou híbrido) e que nível de Shield e Send precisa.
- Piloto controlado: execute em um domínio representativo, defina SLOs e métricas de custo e desempenho.
- Escalonamento iterativo: aprenda com o piloto, ajuste políticas e amplie com governança.
Exemplo conceitual (ilustrativo): uma empresa de logística mantém bancos transacionais em colocation por I/O (Data Center), executa microserviços em plataformas gerenciadas para escalabilidade (Digital), aplica WAF e IDS para proteger APIs (Shield) e usa um broker com fallback multicanal para notificações de entrega (Send). Este exemplo ilustra trade-offs, não é prescritivo.
Critérios objetivos para escolher parceiros e modelos
Perguntas que valem mais que slides comerciais:
- Como o parceiro integra governança de custos ao dia a dia operacional?
- Quais SLAs são mensuráveis e como são apresentados em relatórios?
- O parceiro demonstra runbooks e exercícios de recuperação em escala realista?
- Qual é o nível de automação e até que ponto é parametrizável para sua realidade?
Exija provas de processo: playbooks, demonstrações de failover e políticas de custos, não apenas promessas de uptime.
Padrão operacional recomendado para os primeiros 90 dias
- Semana 1–2: inventário dos três ativos mais críticos, mapeamento de dependências e definição preliminar de SLOs.
- Semana 3–6: piloto técnico em uma aplicação de criticidade baixa a média com tráfego representativo; instrumentação completa e métricas configuradas.
- Semana 7–12: análise de resultados, ajuste de políticas de Shield e integração de Send com fallback; documento de Lições Aprendidas e plano de escalonamento.
Perguntas frequentes
Preciso mover tudo para colocation para ter performance?
Não. Colocation ajuda quando latência e I/O são críticos. Muitas vezes a combinação híbrida é mais eficiente: dados sensíveis ou cargas I/O intensivas em colocation, aplicações front-end e burstable na nuvem.
Automação elimina a necessidade de equipe?
Automação reduz tarefas manuais e acelera resposta, mas não substitui conhecimento humano para decisões de negócio, runbooks e escalonamento de incidentes. Planeje requalificação de times para operar em ambiente automatizado.
Como medir sucesso de um piloto?
Defina SLOs mensuráveis (latência média, percentil 95, RTO, RPO), métricas de custo por transação e indicadores de entregabilidade para Send. Sucesso técnico é acompanhado de validação de custo e operabilidade.
O que a MVX propõe e como iniciar
A MVX adota uma abordagem modular: começamos por diagnosticar ativos críticos e dependências, projetamos um piloto técnico com SLOs definidos e entregáveis claros, e escalamos com governança e checkpoints regulares. A promessa é de trabalho por fases e de adaptar trade-offs ao contexto da sua operação, não de aplicar um pacote único.
Se você quer iniciar o diagnóstico sem compromisso, a MVX oferece um primeiro mapeamento orientado a risco e um plano de 90 dias. Para começar a conversa, acesse o site oficial: MVX.
Checklist rápido antes de qualquer mudança
- Liste três ativos críticos e descreva impacto por falha;
- Defina SLOs mínimos para cada ativo;
- Escolha um domínio representativo para o piloto;
- Estabeleça critérios de sucesso técnicos e de negócio para 90 dias.
Decidir entre Data Center, Digital, Shield e Send exige clareza sobre risco tolerável, custo total e capacidade de operação. Comece pequeno, meça, aprenda e escale com governança. Se preferir uma conversa guiada e um diagnóstico objetivo, acesse MVX e solicite o primeiro mapeamento.